

Como funciona
Os alertas de monitoramento, o Auto-fix e o Auto-republish são configurações separadas. Você pode receber alertas sem permitir que o Agent altere seu código, ou deixar o Agent tentar correções mantendo o controle sobre a publicação. As verificações automáticas observam três sinais: logs de erro da aplicação, erros HTTP e latência das requisições. Essas verificações não cobrem todas as métricas que o Agent pode investigar. Com o Auto-fix ativado, o Monitoring Agent responde aos alertas em segundo plano:1
Investigar o alerta
O Agent usa as métricas de produção, os logs de execução e o código do seu app para
investigar a causa.
2
Tentar e validar uma correção
Quando o Agent identifica uma causa acionável, ele tenta uma correção e valida
a alteração. Um alerta não garante uma correção. Por exemplo, um problema em um
serviço externo pode exigir uma ação fora do seu app.
3
Publicar a correção
Com o Auto-republish ativado, o Agent pode publicar automaticamente sua correção
validada. Caso contrário, revise o resultado no chat do Agent e
republique seu app para colocar a correção no ar.
O Auto-republish é experimental e exige o Auto-fix. O Auto-fix sozinho
não autoriza a publicação de alterações no seu app ao vivo. Algumas alterações, incluindo
migrações e operações de índice, podem ser arriscadas.
Configure o Monitoring Agent
Configure o monitoramento separadamente para cada app publicado. As execuções do Monitoring Agent podem gerar cobranças de uso do Agent. Acompanhe os gastos na sua página de uso.1
Abra as configurações de publicação
Abra a ferramenta Publishing. Para um app já publicado, abra suas configurações
de publicação. Para um app novo, configure o monitoramento durante a primeira publicação.
2
Ative os alertas de monitoramento
Para um app já publicado, ative Monitoring alerts. A alteração
é salva imediatamente, sem republicar. As verificações de uptime são gerenciadas separadamente.Durante a primeira publicação, ative Enable Active monitoring em
Suggested add-ons. Isso também ativa as verificações de uptime onde disponíveis.Este exemplo mostra as configurações da primeira publicação, com o monitoramento ativado e
Auto-fix e Auto-republish ainda desativados.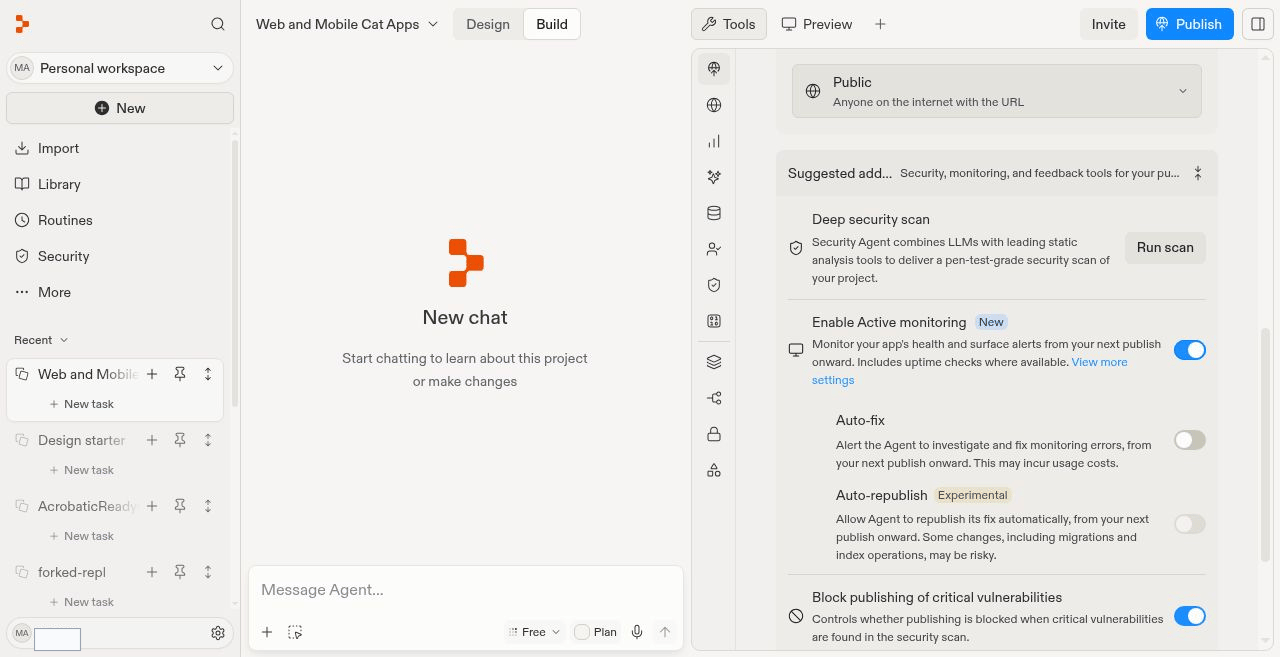
3
Ative as correções automáticas
Ative o Auto-fix para que o Monitoring Agent investigue
e corrija erros de monitoramento.Para um app já publicado, essa alteração é salva imediatamente. Para um app novo,
selecione Publish para aplicar suas configurações e iniciar o monitoramento.
4
Escolha se deseja republicar automaticamente
Ative o Auto-republish para que o Agent publique suas correções automaticamente.
Deixe-o desativado se quiser revisar e publicar as alterações você mesmo.Para um app já publicado, essa alteração é salva imediatamente. Para um app novo,
a configuração entra em vigor a partir da sua primeira publicação.
Revise os alertas
Abra a ferramenta Monitoring e encontre a tabela Monitoring alerts:- Active: Problemas que afetam seu app no momento.
- Resolved: Problemas que deixaram de afetar seu app nos últimos 30 dias.
Preferências de e-mail
Abra Settings > Notifications e encontre Active monitoring alerts para controlar seus e-mails de alerta.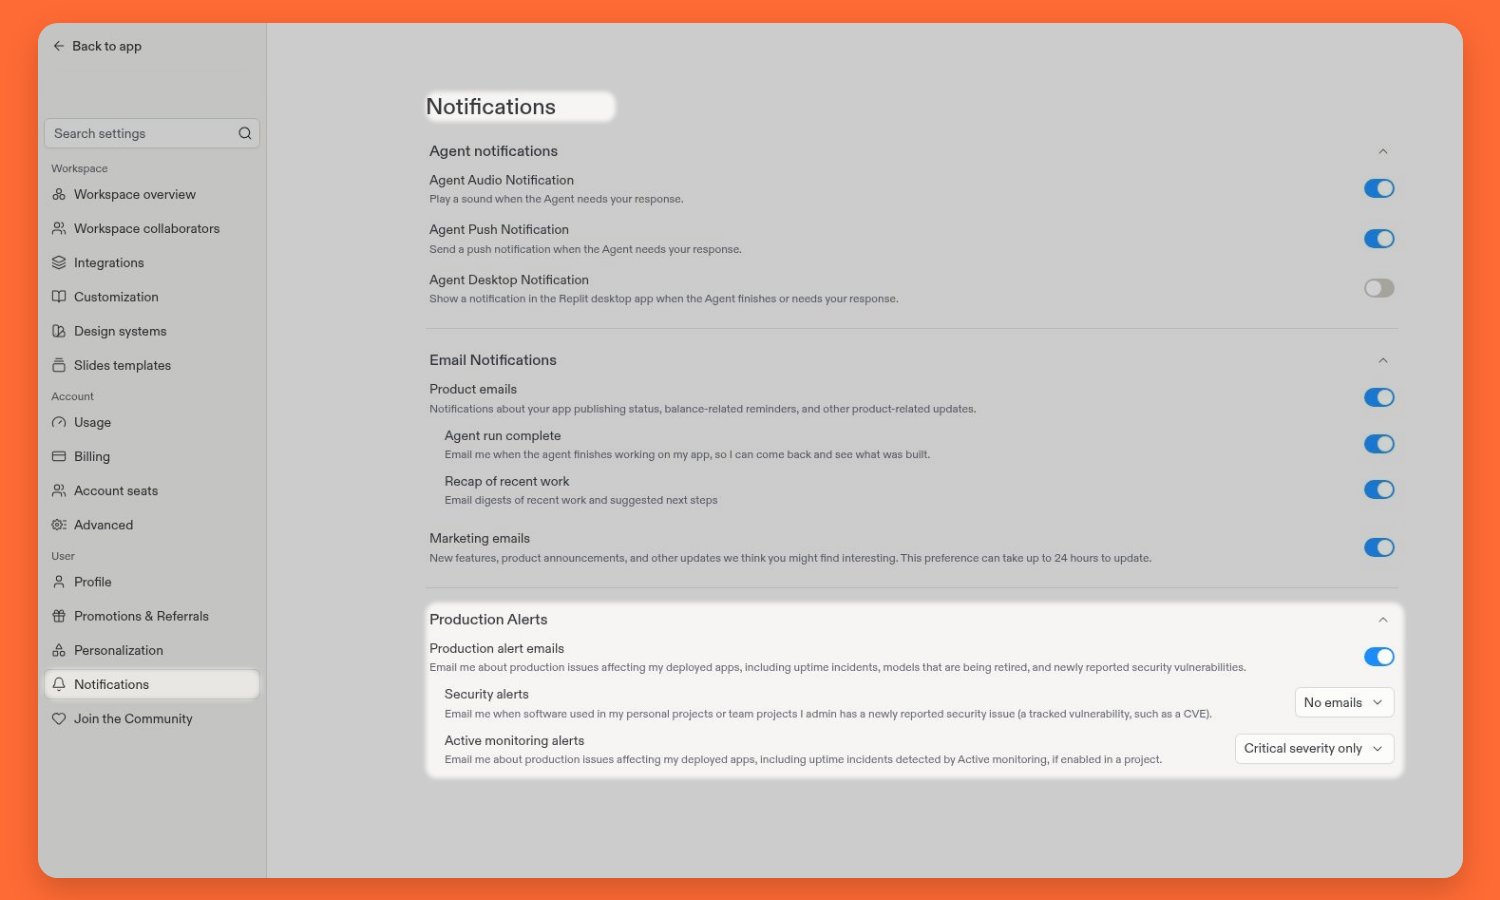
Pergunte ao Agent sobre a produção
Você não precisa esperar por um alerta nem ativar o Auto-fix para perguntar ao Agent sobre seu app publicado. Experimente prompts como:- “Por que meu app retornou erros 500 na última hora?”
- “Quais endpoints foram mais lentos hoje? Compare a latência p50 e p99 deles.”
- “Verifique o uso de CPU e memória desde minha última publicação.”
- “Leia os logs de execução da revisão que falhou ao iniciar.”
Telemetria disponível
O Agent pode consultar mais telemetria sob demanda do que os três sinais usados para os alertas automáticos. As métricas disponíveis dependem do seu tipo de deployment e do provedor de nuvem.- HTTP traffic: Contagem de requisições, latência das requisições, contagens de respostas 4xx e 5xx e disponibilidade.
- Endpoint performance: Contagem de requisições, latência e contagens de respostas 4xx e 5xx para cada endpoint. A latência inclui valores médios, p50, p95 e p99.
- Compute: Utilização de CPU e memória, contagem de instâncias ativas, latência de inicialização e uptime das instâncias.
- Storage and network: Uso de disco, utilização de disco e egress de rede.
- Application errors: Contagem de logs de erro e logs de execução filtrados por severidade ou revisão do deployment.
Próximos passos
- Monitoring: Inspecione a saúde, o uso de recursos e os logs do seu app.
- Depois de publicar: Revise e publique alterações no seu app ao vivo.
- Gerenciar gastos: Acompanhe o uso e controle os custos.